Lokale KI auf Augenhöhe.
Souverän. Konkret.
Workshops, Prototypen und lokale KI-Hardware für Teams, die KI verstehen wollen — statt sie nur zu mieten. Seit 2023 in der Tiefe. Seit Ende 2024 produktiv im Markt.
2026 ist KI keine Frage mehr — die Frage ist, wem Sie Ihre Daten anvertrauen. Cloud-KI ist bequem. Lokale KI ist souverän. Wir bauen mit Ihnen die zweite Variante. Und ja: In vielen Fällen wird sie günstiger sein.
im Haus.
DSGVO- und AI-Act-konform nicht durch juristische Konstruktion, sondern durch echte On-Premise-Inferenz. Keine Auftragsverarbeitungsverträge, kein Cloud-Act-Risiko.
wenn Sie fit sind.
Wir kommen rein, arbeiten Schulter an Schulter mit Ihrem Team und gehen wieder. Das Ziel ist Ihre Unabhängigkeit — kein Lock-in.
statt Mietserver.
Bis zu 1.200 GB/s Speicherbandbreite (Mac Studio M5 Ultra), überschaubare Stromaufnahme, kein Rechenzentrum-Lärm. Lokale Inferenz wird damit in vielen Fällen günstiger sein als Cloud-Alternativen.
Design-DNA.
Tech-Tiefe.
Seit 2009.
2009 in Köln gegründet, seit Oktober 2025 auch in Weimar: Jessica Rudzki und Stephan Schug bringen zusammen, was im KI-Markt selten ist — jahrzehntelange Vermittlungskompetenz aus Design und Web und echte technische Tiefe in Python, TypeScript, lokalen LLMs, RAG und Feintuning.
KI wird bei uns nicht von Data-Scientists auf Organisationen losgelassen. Sie wird von Menschen eingeführt, die seit Jahrzehnten gestalten, erklären und Software in real existierende Unternehmen integrieren. Das ist der Unterschied.
Drei Angebote.
Ein Versprechen.
Prototypen
Vom Use Case zum lauffähigen Prototyp — Schulter an Schulter mit Ihren Entwickler:innen.
- Use-Case-Ermittlung & Ideation mit Design-Thinking-Werkzeugen
- Hands-on-Implementierung: Python / TypeScript / lokale LLMs / RAG-Pipelines
- Iterative Entwicklung im Repository Ihres Teams, transparent dokumentiert
- Proof of Concept mit klaren Erfolgskriterien — kein Demo-Theater
KI-Schulungen
Drei Tracks. Zwei Stunden bis drei Tage. Passend zu Ihrem Haus — nicht zu unserer Folienbibliothek.
- Track Anwender: Prompting, Tools, Tagesgeschäft
- Track Entscheider: Use-Case-Bewertung, Risiko, Governance
- Track Entwickler: Architektur, Eval, RAG, lokale Modelle
- Erfüllung der AI-Literacy-Pflicht (Art. 4 EU AI Act) dokumentierbar
- Immer use-case-spezifisch — keine Standardpräsentation
Entwicklung
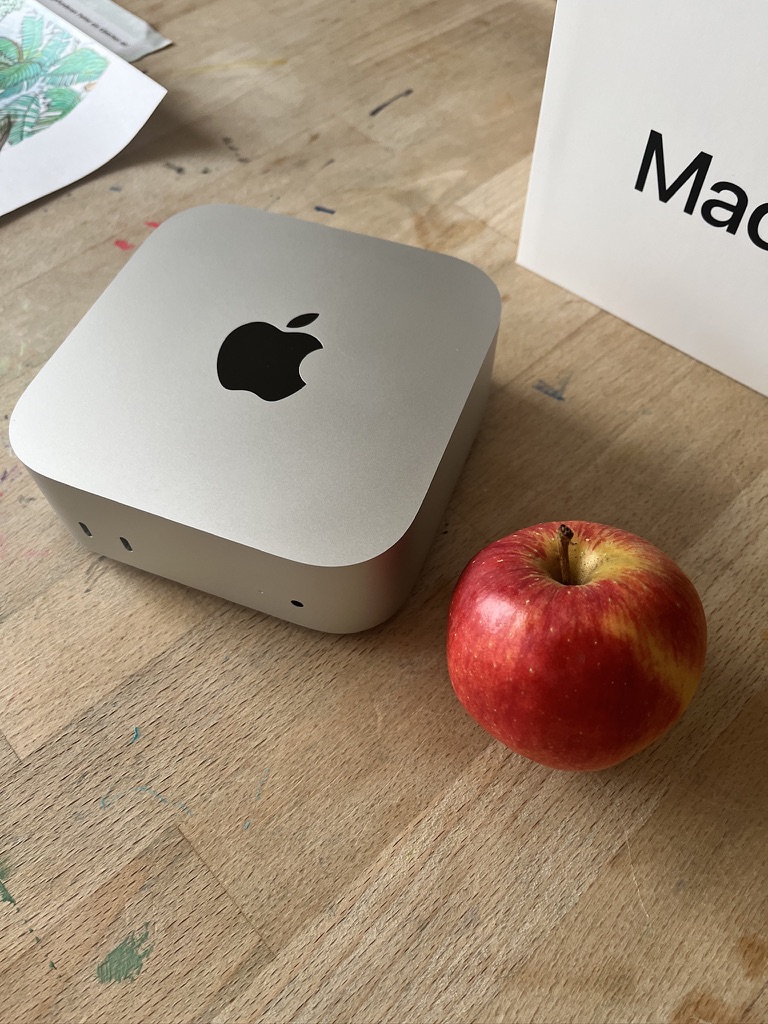
Eigene Apple- oder Nvidia-Hardware als ernstzunehmende Alternative zu Cloud-GPU.
- Beratung, Beschaffung, Aufbau, Onboarding aus einer Hand
- Unified Memory — große Modelle laufen vollständig im Speicher
- Stromaufnahme 2–9 W im Leerlauf, bei Einzelnutzung typisch 25–55 W (gemessen an Mac mini M4 und Mac Studio M1 Max)
- MLX, llama.cpp, Ollama, vLLM (vllm-metal), oMLX, LM Studio, Unsloth Studio, EXO — ausgereifte Toolchain, teils Beta
- Hybride Setups (DGX Spark + Apple Silicon) auf Wunsch
Hinweis zur Lieferbarkeit: Apple hat am 25. August 2026 die neue Generation vorgestellt, ausgeliefert wird ab 22. September 2026. Unsere KI-Boxen basieren auf dem Mac mini M6 mit 32 GB Arbeitsspeicher (für 48 oder 64 GB ist zwingend die parallel weiterverkaufte M5-Pro-Variante Voraussetzung) bzw. auf dem Mac Studio (18 C/40 G) mit 64 GB Arbeitsspeicher (Konfigurationen mit 256 GB Arbeitsspeicher sind verfügbar, eine 512-GB-Konfiguration ist angekündigt, war zum Marktstart aber nicht bestellbar und ist von Apple noch nicht bepreist). Die Lieferzeiten sind aktuell sehr volatil. Bis zur Auslieferung bzw. bei Engpässen beschaffen wir alternativ verfügbare Nvidia DGX-Spark- oder Apple-Refurbished-Setups. [Stand: 19. Oktober 2026]
Technische Argumente →Konkret.
Ohne Weichzeichner.
Sie kennen Nvidia. CUDA ist seit fast zwei Jahrzehnten der Standard. Wir respektieren das — und machen trotzdem das Gegenangebot. Nicht aus Apple-Überzeugung, sondern aus Speicherbandbreiten-Arithmetik.
| Arbeitsspeicher | Beispiel-Hardware | Sinnvolle Modelle (4-bit) |
|---|---|---|
| 16 GB | Mac mini M4 | Gemma 4 E4B und 12B |
| 24–32 GB | MacBook Air M3, Mac mini M6 | Gemma 4 26B A4B (ca. 14 GB), Qwen3.8-27B (ca. 18 GB), Qwen3.6-35B-A3B (ca. 24 GB, ab 32 GB) |
| 64 GB | Mac Studio M1 Max, Mac mini M5 Pro | dieselben Modelle in höherer Qualität (8-bit) und mit langem Kontext |
| 128 GB | Mac Studio M5 Max/Ultra, DGX Spark | gpt-oss-120b, Mistral Small 4, Qwen3.5-122B-A10B (je ca. 65–75 GB) |
| 256 GB | Mac Studio M5 Ultra | MiniMax-M2.5 (229B, ca. 138 GB) |
| ab ca. 400 GB | Cluster oder Cloud | Kimi K2.6, DeepSeek-Klasse |
Gut zu wissen: Der Mac mini M6 endet bei 32 GB, für 48 oder 64 GB brauchen Sie den M5 Pro. Nicht jedes offene Modell ist frei kommerziell nutzbar, die Lizenz prüfen wir für Sie.
Unser Standpunkt: Für PoCs und den Betrieb bis etwa 120B (MoE) ist Apple Silicon oft die wirtschaftlichere Wahl. LoRA-Feintuning bis ca. 30B geht auch auf dem Mac. Training großer Modelle bleibt CUDA-Domäne. Ehrlich.
- Hardware: KI-Box „lokal“ auf Apple-Basis ab 2.750 €, auf NVIDIA DGX Spark ab 7.750 €. Einrichtung und 2 Stunden Onboarding sind enthalten. Für große Modelle: Mac Studio M5 Ultra mit 256 GB ab 10.999 € (Apple-Preis, inkl. Mehrwertsteuer).
- Befähigung: KI-Deep-Dive ab 450 € (2 Stunden), ab 850 € (halber Tag) oder ab 1.650 € (ganzer Tag) pro Gruppe bis 5 Personen. Weitere KI-Leistungen: 120 € pro Stunde bzw. 960 € pro Tag.
- Strom: je nach Gerät rund 20–850 € pro Jahr (siehe „Stromverbrauch“).
- Pflege und PoC: Proof of Concept und Wartung bieten wir individuell an.
- KI-Box Apple: ca. 4.400 €. Bei 300 € Cloud-Kosten im Monat ist sie nach etwa 15 Monaten bezahlt.
- KI-Box DGX Spark: ca. 9.400 €. Bei 600 € im Monat sind es etwa 16 Monate.
| Gerät | Leerlauf | unter KI-Last | Kosten/Jahr* | Art der Angabe |
|---|---|---|---|---|
| Mac mini M4 | 2–7 W | 25–45 W | ca. 20–40 € | gemessen, KI-Lab Weimar (1 Nutzer) |
| Mac Studio M1 Max | 9 W | 25–55 W | ca. 35–50 € | gemessen, KI-Lab Weimar (1 Nutzer) |
| Mac Studio M5 Ultra | 9 W (Apple) | ca. 150–250 W | ca. 110–170 € | Leerlauf Apple, Last geschätzt |
| NVIDIA DGX Spark | 25–38 W | ca. 60–100 W | ca. 110–140 € | NVIDIA, Messungen ServeTheHome, Tom's Hardware |
| Workstation RTX 5090 | ca. 70–120 W | ca. 450–750 W | ca. 560 € | System geschätzt, Kartenwerte Igor's Lab |
| Workstation RTX PRO 6000 | ca. 150 W | ca. 900 W | ca. 850 € | StorageReview (Bildgenerierung) |
- Ollama (stabil): Der einfachste Einstieg. Ab Version 0.40 nutzt es auf Apple Silicon automatisch MLX.
- LM Studio (stabil): Desktop-App mit Oberfläche, ideal für Fachanwender ohne Kommandozeile.
- llama.cpp (stabil): Der De-facto-Standard, läuft auf Mac, Linux und DGX Spark.
- MLX / mlx-lm (stabil): Apples natives Framework und die schnellste Basis auf dem Mac, auch für LoRA.
- oMLX (jung, aktiv): Macht einen Mac zum Team-Server mit parallelen Anfragen und SSD-Cache für lange Kontexte.
- vLLM (stabil auf NVIDIA): Standard für viele gleichzeitige Nutzer. Auf dem Mac gibt es das noch junge Plugin vllm-metal.
- Unsloth Studio (Beta): Feintuning per LoRA/QLoRA, auf NVIDIA ausgereift, auf dem Mac seit Herbst 2026 per MLX möglich.
- EXO: Verbindet mehrere Geräte zum Cluster.
- DSGVO: Lokal braucht keine Auftragsverarbeitung und keine Drittlandprüfung. Für den Cloud-Anteil regeln wir den AVV.
- § 203 StGB: Berufsgeheimnisträger dürfen Daten nur unter engen Voraussetzungen an externe Dienstleister geben. Lokale Verarbeitung vermeidet das Problem.
- EU AI Act: Die KI-Kompetenzpflicht (Art. 4) gilt für lokale und Cloud-KI. Ein dokumentiertes Routing zeigt, welche Daten wohin gehen.
Wir verkaufen kein Tool, sondern empfehlen die passende Topologie, auch wenn das nur ein Mac mini ist.
Handlungsfähig.
Rechtssicher. 2026.
Wir bringen Ihr Team in einen handlungsfähigen, rechtssicheren KI-Modus — maßgeschneidert auf Ihre Use Cases, nicht von der Stange.
AI Act & DSGVO
Art. 4 EU AI Act verpflichtet zu Maßnahmen für KI-Kompetenz im Personal (seit 02.02.2025; seit dem KI-Omnibus vom 27.07.2026 ohne Garantie eines bestimmten Kompetenzniveaus). Hochrisiko-Pflichten greifen später (Anhang III ab 02.12.2027). Bußgelder können existenzbedrohend sein.
Schatten-IT stoppen
Ihre Mitarbeitenden nutzen Cloud-KI längst — nur nicht sicher. Lokale KI-Lösungen eliminieren das DSGVO-Risiko strukturell, nicht durch Verbote.
Wettbewerbsfähigkeit
41 % der deutschen Unternehmen nutzen KI aktiv (Bitkom 2026) — 59 % noch nicht. Den Einstieg gestalten wir mit Ihnen — lokal und souverän.
Vier Schritte.
Ein Ziel.
Use-Case-Workshop, Ist-Analyse, Hardware-Sizing. Wir hören zu, bevor wir bauen.
PoC / Prototyp, lokal oder hybrid, Schulter an Schulter mit Ihrem Entwicklerteam. Kein Demo-Theater.
Schulungen für Anwender, Entscheider, Entwickler — dokumentiert, use-case-spezifisch, AI-Act-konform.
Wir gehen. Ihr Team kann. Das war immer der Plan.
— Bis Sie fit sind.
Fakten, keine
Versprechen.
FAQ
Tech-Sparring
buchen
30 Minuten, kostenlos. Architektur, Hardware-Sizing, Stack-Fragen — ohne Verkaufsdruck. Ehrliche Einschätzung, ob und wie wir helfen können.
Tech-Sparring vereinbaren → Architektur-Skizze anfordernStrategiegespräch
vereinbaren
45 Minuten. Use Cases, Compliance-Status, Fördermöglichkeiten, realistischer Einstiegspfad. Maßgeschneidert auf Ihr Unternehmen.
Strategiegespräch buchen → KI-Kompetenz-Check anfragen